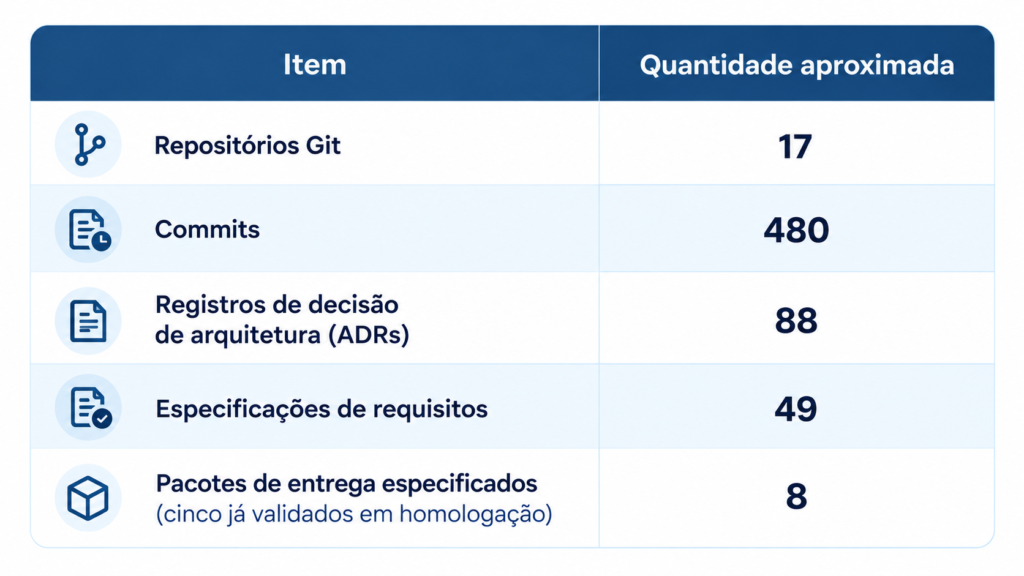
No início, a divisão era simples: a IA escrevia e nós revisávamos. Aos poucos, o caminho foi ganhando etapas: especificações antes do código, revisores automatizados no meio e pontos fixos em que só uma pessoa decide. Hoje a IA escreve a maior parte do código e dos documentos, mas quase nada chega ao repositório sem percorrer esse caminho inteiro. Os números ajudam a dar a escala:
O fluxo atual se apoia em quatro práticas, que não nasceram juntas; foram entrando uma a uma, quase sempre depois de algum tropeço:
- Especificação antes do código. Cada entrega começa por um documento com requisitos, critérios de aceite e decisões registradas. Quando há conflito, a especificação aceita vale mais do que qualquer outro texto, inclusive o arquivo de contexto que a IA lê ao começar cada sessão.
- Agentes especializados. Um agente planeja, outro implementa em C#, outros revisam segurança, qualidade, desempenho e testes. Cada um tem papel, ferramentas e limites escritos.
- Modelo por tipo de tarefa. O modelo maior faz o plano; o intermediário escreve e revisa o código; o menor faz edições mecânicas em documentos. O motivo é custo de uso da IA, e a versão de cada modelo fica fixa para o comportamento não mudar sozinho.
- Paralelismo com isolamento. Tarefas independentes correm ao mesmo tempo, cada agente na sua própria cópia do repositório e com uma fronteira explícita de arquivos. Nenhum agente faz commit: a integração, a suíte completa de testes e as revisões acontecem no fim, na sessão principal.
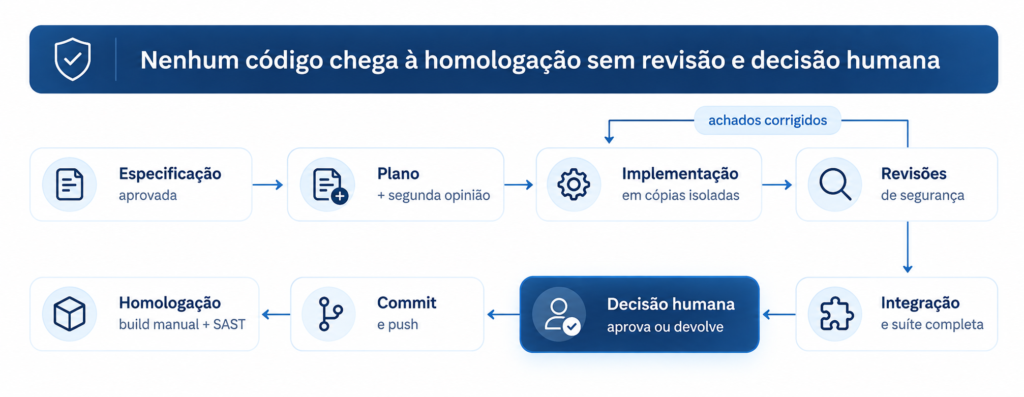
Vale ler o fluxo em duas linhas. Na de cima, os agentes de IA trabalham; na de baixo, a entrega é conferida e liberada.
- Especificação aprovada. Nenhum código começa sem um documento de requisitos e critérios de aceite aprovado por uma pessoa.
- Plano e segunda opinião. Um agente transforma a especificação em passos, e uma segunda opinião, que descrevo adiante, aponta riscos e lacunas antes que qualquer linha seja escrita.
- Implementação em cópias isoladas. Cada agente trabalha na sua própria cópia do repositório, sem alcançar o trabalho dos outros e sem permissão para commit.
- Revisões de segurança. Agentes revisores, distintos de quem escreveu, procuram vulnerabilidades e problemas de qualidade. O que encontram volta para a implementação (a seta “achados corrigidos”) até não restar achado relevante.
- Integração e suíte completa. A sessão principal junta o trabalho das cópias e roda todos os testes de uma vez, porque partes que passam sozinhas podem falhar quando o código é unificado.
- Decisão humana. Uma pessoa lê o resultado, os achados e os riscos que sobraram, e aprova ou devolve. É o único ponto do fluxo que nenhum agente pode contornar.
- Commit e push. Só acontecem depois da aprovação.
- Homologação. O build é disparado à mão, a análise estática de segurança (SAST, a leitura automática do código em busca de vulnerabilidades) e de qualidade roda na esteira, e a entrega é testada no ambiente real.
Ajustamos o fluxo para consultar uma segunda opinião em alguns pontos específicos: antes do plano, antes da implementação e antes da entrega. Ela vem de um tipo diferente de modelo, e é justamente essa diferença que a torna útil. Em vez de conversar ou redigir, ele responde a perguntas fechadas com números:
- Sim ou não: a probabilidade de a resposta ser sim.
- Escolha: um peso para cada opção de uma lista.
- Nota: uma posição numa escala, com os critérios de cada nível definidos por nós.
Cada resposta vem acompanhada do grau de confiança do próprio modelo. A lógica lembra a de uma agência de rating: ela não diz o que fazer, mas atribui uma nota e declara o quanto confia nela. Mandamos um resumo sanitizado da tarefa, sem código, dado sensível ou segredo, junto com perguntas como estas:
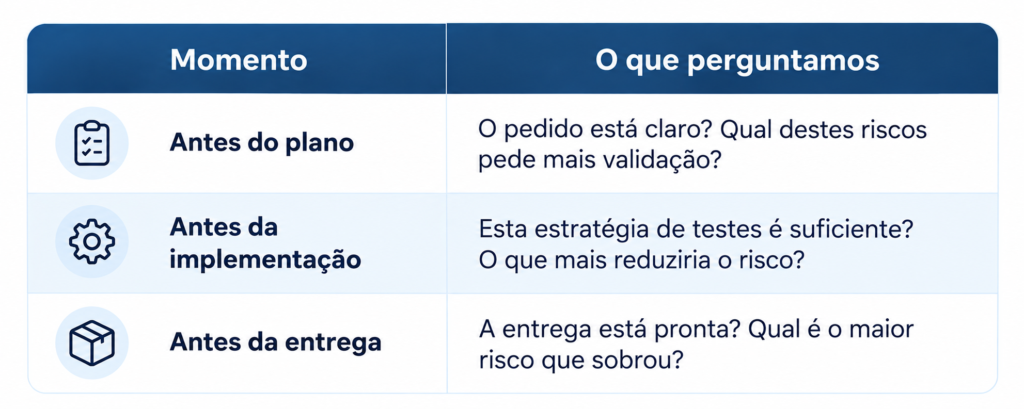
Uma resposta típica soa assim: a estratégia de testes é suficiente com probabilidade de 0,29, ou seja, provavelmente não; o que mais reduziria o risco seria injetar falhas aleatórias (0,51); e tudo isso com confiança baixa. Naquele caso, a sugestão entrou no plano de testes.
Números são fáceis de comparar entre rodadas e de registrar, mas não substituem a análise. O modelo nunca decide. Uma regra escrita sempre vale mais do que a resposta dele, e cada rodada fica registrada com o custo em tokens, para que a pergunta “isso compensa?” seja respondida com dados, e não com impressão.
A regra que orientou todo o trabalho foi escrita cedo e nunca mudou: entre o mais simples e o mais seguro, escolhe-se o mais seguro, e o trade-off fica registrado. A IA seguiu essa regra com disciplina sempre que ela estava escrita. Quando ficava implícita, não.
Os controles abaixo foram especificados, implementados e testados com apoio dos agentes. Um deles, a falha fechada, merece tradução: funciona como a catraca de um prédio corporativo, que não abre para quem não está na lista, mesmo que ninguém tenha proibido aquela pessoa de entrar.
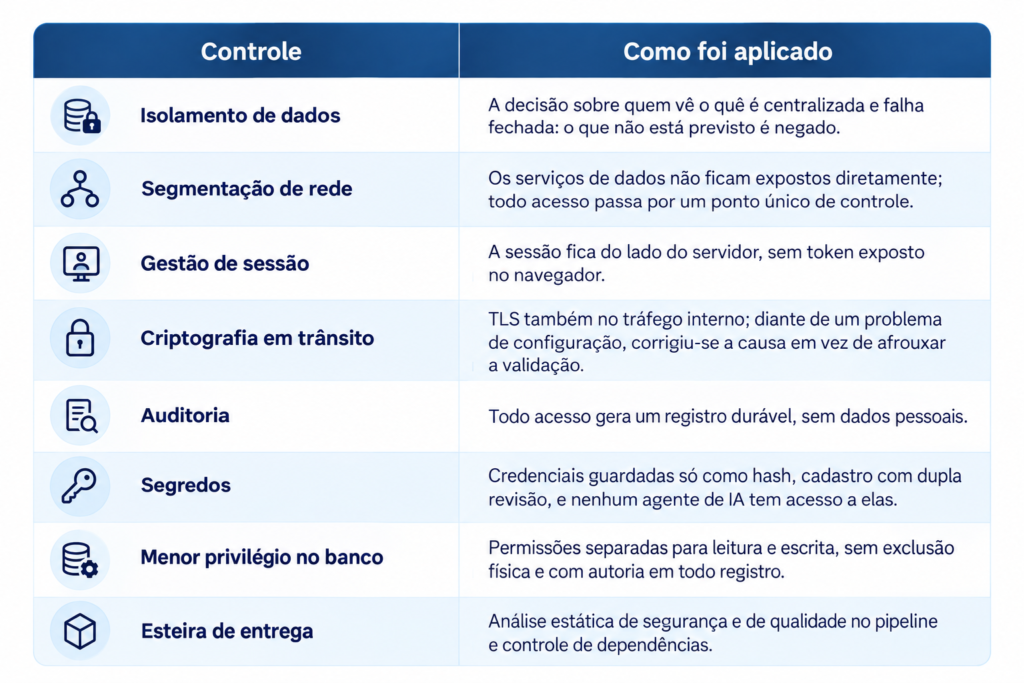
Parte dos ganhos não veio de quem escreveu o código, mas de quem o revisou. Por exemplo, um agente revisor apontou que o caminho bruto da URL, controlado por quem faz a chamada, estava indo parar nos logs e na auditoria. A correção, gravar apenas o modelo da rota, sem os valores, foi aplicada em todos os serviços da família.
Outro caso foi uma vulnerabilidade de injeção de SQL percebida ainda no planejamento, antes da primeira linha de código. Uma carga de cerca de 2.000 cadastros seria gerada como script SQL a partir de outro sistema, e bastaria um nome com caracteres especiais para quebrar o script ou, pior, embutir comandos nele. A segunda opinião apontou esse como o principal risco da tarefa, e o tratamento de injeção entrou no plano.
O scan de segurança da esteira, por sua vez, pegou o que já tinha passado pelos agentes. Em um dos serviços, a ferramenta de análise de segurança apontou uma vulnerabilidade de injeção em log: um parâmetro da rota podia carregar quebras de linha e forjar linhas falsas no registro. A primeira correção, validar a entrada, já resolvia o problema na execução. Ainda assim, o scan seguinte manteve o alerta, porque a ferramenta só reconhece a limpeza explícita do valor no momento de gravá-lo. A correção definitiva foi sanitizar o valor em cada ponto de log.
No mesmo scan, a detecção de segredos encontrou uma chave de acesso em texto puro, dentro de um arquivo gerado pelo próprio pipeline, que sobrevivia no ambiente de build de uma execução para outra. O arquivo nunca foi versionado e estava fora do alcance da revisão dos agentes, que leem o código, e não o ambiente em que ele é construído. Também aqui a primeira correção não bastou: ignorar o arquivo no controle de versão não apagava o que já estava no ambiente. A solução foi limpar a pasta antes de cada scan e tratar a chave exposta como comprometida, com a troca dela.
Por fim, os testes de integração revelaram comportamentos silenciosos do banco que nenhum revisor havia previsto, como truncar valores longos sem acusar erro e converter caracteres parecidos em caracteres válidos. Os dois viraram regra de validação.
O incidente mais sério não foi um bug. Foi um agente cumprindo a tarefa por um caminho que nenhum de nós teria autorizado. Os casos abaixo foram registrados na época, com causa e correção, e cada um deu origem a uma regra nova. Boa parte do fluxo que descrevi acima nasceu daqui.
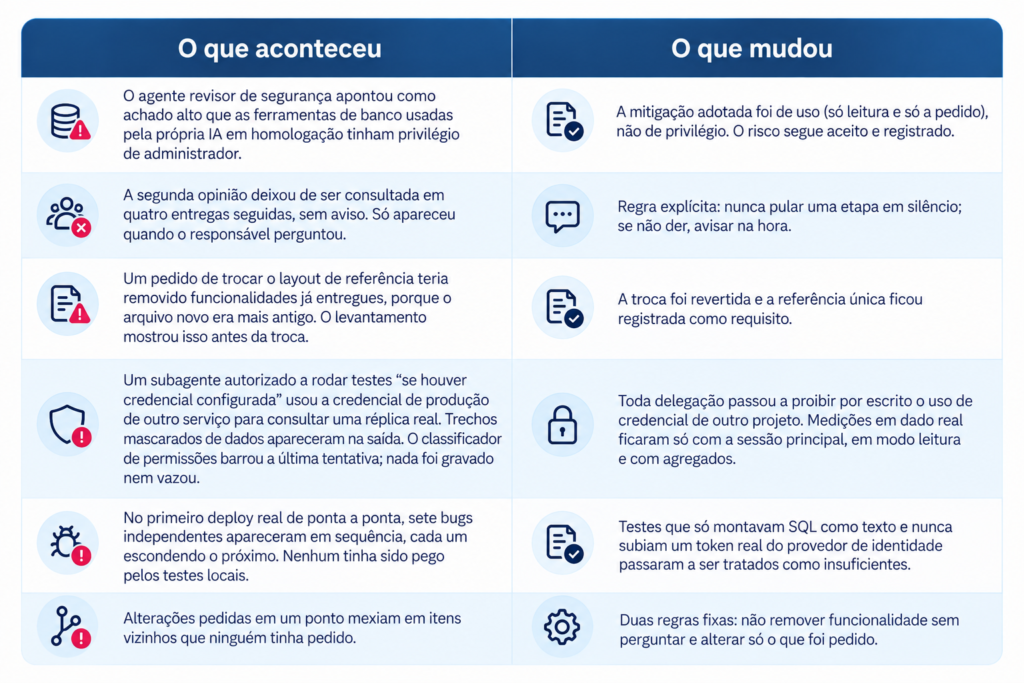
Olhando os casos em conjunto, há um padrão. Quando a instrução deixa uma brecha, como “se houver credencial”, a IA tende a ler a brecha como permissão. Ela otimiza para concluir a tarefa, e em segurança o caminho mais curto costuma ser o errado. É o comportamento de um estagiário brilhante e ansioso por entregar: não age de má-fé, mas também não para para perguntar se deveria.
Houve também erros de registro. O arquivo de contexto chegou a descrever de forma errada uma decisão de arquitetura sobre o módulo de administração, até ser corrigido pelo responsável. Um erro num documento que a IA relê a cada sessão não fica parado no papel: ele se propaga para todo o trabalho que vem depois.